
雖然昨天說要開始來做上下文壓縮,但是,在這之前,我覺得應該要先來做可以看上下文佔用的功能,這樣我們才可以有感地體驗到壓縮的感覺。
今天,我們完成它的前半部分,馬上開始吧!
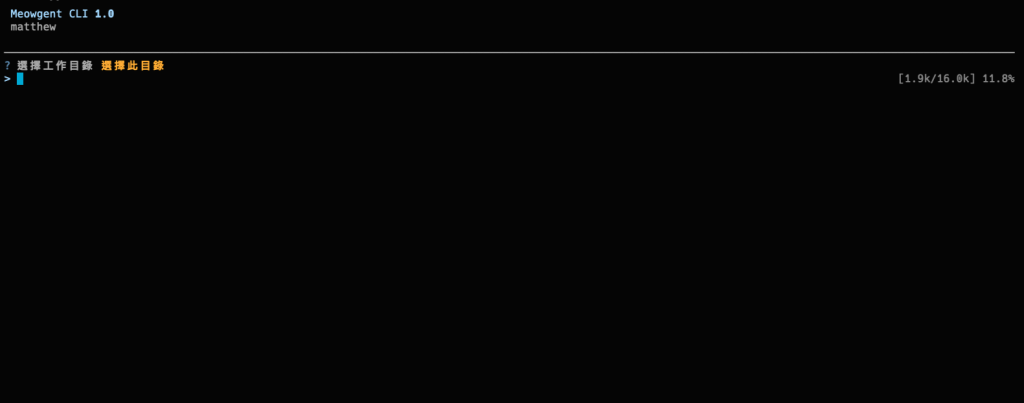
先看一下完成的效果如下:
右方顯示
[1.9k/16.0k] 11.8%。
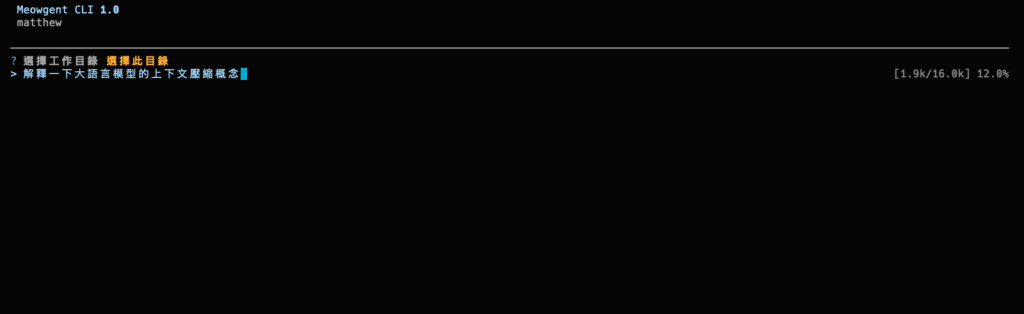
輸入完,馬上多了一點:
變成 12% 了!
模型回答完,又多了更多: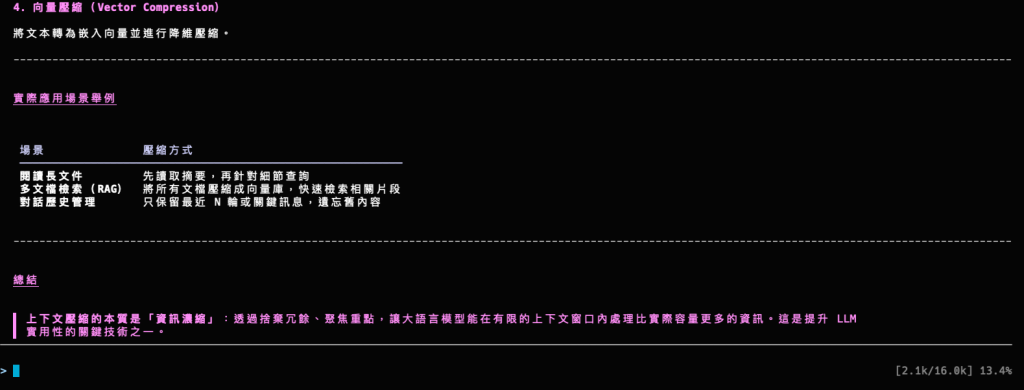
而當輸入訊息太長時也無需擔心,佔用顯示會自動消失,如下兩圖: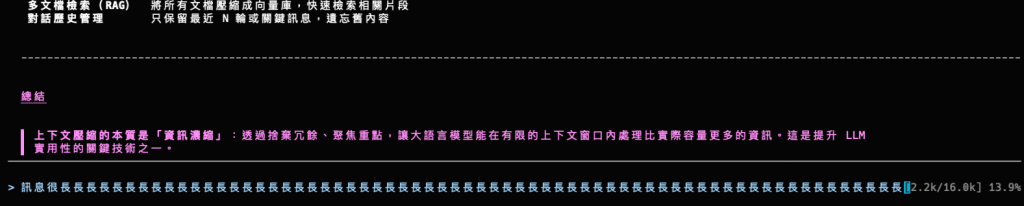
分為兩種數據形式:
由於 Ollama 提供的數據要等到輸出完畢才能取得,沒辦法做到邊輸入邊進行即時更新,因此我們會以估算的方式作為輔助。
這裡,先來實作第二點提到的函數:
這個函數只專注於把「傳入的文字估算為 token 數」。
# src/meowgent/agent.py
...

def estimate_token(text: str) -> int:
    """ 估算出傳入文字的 token 量 """

class Agent():
	...
一般來說,中日韓文與全形標點一個字元大致約為「1.3 token」,而一般的半形英文、數字與標點符號則是約「3.5 個字元」為 1 token,
我們先用正則抓出前者:
同樣是採用了預編譯。
# src/meowgent/agent.py
...
RX...
RX_CJK_PATTERN = re.compile(r'[\u4e00-\u9fff\u3000-\u303f\uff00-\uffef]')

...
這些看起來像亂碼的是 Unicode 編碼點(Code Point)的十六進位代號:
\u4e00-\u9fff:中日韓統一表意文字。\u3000-\u303f:中日韓符號和標點(全形,涵蓋全形空格(\u3000)、書名號(《》)、引號(「」『』)、句號(。)、頓號(、)等)。\uff00-\uffef:半形及全形形式(涵蓋全形英文字母、全形數字、全形標點(,、!、?、:)及日語半形假名)。
首先,先把找到的樣式數量做統計(cjk_count),然後用總長扣掉就是剩餘其他字元的長度,拿到數量後進行計算,最後轉為整數。
這邊計算出來的原本是浮點數,而因為 token 沒有小數點,所以直接拿
int()轉換,
它的方式為「向 0 靠攏」,如果是 3.8 會變 3,-2.5 會變 -2(這邊不會有負數出現,只是解釋int())。
# src/meowgent/agent.py
...

def estimate_token(...) -> ...:

	# 中日韓文、全形標點
    cjk_count = len(RX_CJK_PATTERN.findall(text))

    # 其餘字元(英文、數字、程式碼標點、半形空白等)
    other_chars_count = len(text) - cjk_count

    # 中文每字約 1.3 token,其餘每 3.5 字元約 1 token
    return int((cjk_count * 1.3) + (other_chars_count / 3.5))

...
馬上,我們來實作負責產生顯示文字的 get_context_status_text()!
先說一下它被調用的時機,方便下面的理解:
[ main.py 執行 get_input(),呼叫 prompt("> ") ]
                     │
                     ▼
[ 1. prompt_toolkit 繪製初始終端畫面與輸入提示字元 "> " ]
                     │
                     ▼
[ 2. 佈局引擎準備繪製右側 rprompt,向回呼函式要文字 ]
                     │
                     ▼
[ 3. 執行 _dynamic_rprompt(),讀取當前緩衝區文字(此時為空字串 "") ]
                     │
                     ▼
[ 4. 首次呼叫 get_context_status_text(user_input="") ]
     • 讀取目前 System Prompt + 歷史對話(或 Ollama 的 true_token)
     • 計算出此時的基準歷史水位
                     │
                     ▼
[ 5. 終端機最右側印出初始狀態,例如:[2.4k/16.0k] 15.3% ]
[ 使用者敲擊鍵盤、貼上大段程式碼、或按 Backspace 刪字 ]
                     │
                     ▼
[ 1. 捕捉鍵盤事件,文字寫入輸入緩衝區(Buffer) ]
                     │
                     ▼
[ 2. 緩衝區內容改變,觸發終端機「重繪畫面(Redraw)」 ]
                     │
                     ▼
[ 3. 重新計算右側提示:主動執行回呼函式 _dynamic_rprompt() ]
                     │
                     ▼
[ 4. 再次呼叫 get_context_status_text(user_input=最新打的字) ]
     • 基礎歷史基準 + 提示詞差量 + 當前打字的預估 Token
                     │
                     ▼
[ 5. 終端機右側即時跳動刷新,例如跳至:[3.8k/16.0k] 23.7% ]
[ 使用者按下 Enter 送出這輪問題 ]
                     │
                     ▼
[ 1. 當前輸入行與右側數值「定格」在終端機上,開始執行 model.chat() ]
                     │
                     ▼
[ 2. 模型思考、調用工具、輸出完畢,Ollama 傳回真實 Token 存入 true_token ]
                     │
                     ▼
[ 3. main.py 的 while 迴圈重新開始,再次呼叫 get_input() ]
                     │
                     ▼
[ 4. 重新觸發「時機一」,此時 get_context_status_text() 呼叫時 ]
     直接以剛拿到的 Ollama 真實 Token 作為全新的起始基準!
為什麼要新舊兩個都拿呢?
當使用者輸入問題,模型取得了第一版 system prompt,而第二次輸入時,使用者更改了 system prompt,我們要計算這兩個版本的 token 差距,來較精準地估算出 token 數。
這邊不能用
chat()裡拿的 system prompt,因為在此時,chat()還未被呼叫。
但有注意到嗎?此處呼叫與Agent.chat()內部傳給get_system_prompt()的參數不大一樣(沒有特別過濾tool_list),這是我為了省麻煩偷的懶,
在此處估算時不追求極度嚴苛的工具過濾(直接預設允許全部工具)。
true_token是由 ollama 回傳的真實 token 數量,先不管它怎麼來的,我們晚點再看。
# src/meowgent/agent.py
...
class Agent():
	...
	def __init__(...):
		...
		self.true_token: Optional[int] = None # 由 ollama 回傳的真實 token 數量
		self.last_system_prompt: Optional[str] = None # 記錄上次生效的提示詞

	def get_context_status_text(
		self,
		user_input: Optional[str] = None
	) -> Optional[str]:
        """ 獲取上下文佔用文字 """

        system_prompt = get_system_prompt(
            model_name=self.model_name,
            path=self.path,
            rule=self.rule,
            enable_tools=True
        )
這邊,我把最大上下文也加到了設定檔之中:
# src/meowgent/config/config_schema.py
...

class ModelsConfig(BaseModel):
	...

	max_context: int = Field(
        default=16384,
        ge=0,
        description="模型的最大上下文 token"
    )
...
# src/meowgent/cli/main.py
...
if __name__ == "__main__":
	...

	model = Agent(
        OllamaProvider(
            ...,
            context=config.models.max_context
        ),
        ...
    )
# src/meowgent/providers/ollama_provider.py
...
class OllamaProvider(...):
    def __init__(..., context: int = 16384):
        ...
        self.context = context

    def stream_generate(...) -> ...:
	    response = ollama.chat(
            ...,
            options={
                "num_ctx": self.context,
                ...
            }
        )
然後,我們就可以取出 OllamaProvider 物件裡的 self.context 了:
# src/meowgent/agent.py
...
class Agent():
	...

	def get_context_status_text(...) -> ...:
		...

		max_context = getattr(self.provider, "context", 16384)
		# 獲取 OllamaProvider 物件的 self.context

        max_context_k = round(max_context / 1000, 1) # 轉換為 k,並四捨六入
如果已經有了 Ollama 傳來的真實 token,我們會以此為基礎來做計算。
回傳說截至上次,提示詞輸入加上輸出佔據了 10k,而我們繼續以這個 10k 來做計算,
簡單來說,「已經有準確答案的部分,就不要用估算的」。
而這邊還要處理「system prompt」更新的問題,當新舊 prompt 不同時,要把差值一併計算進去。
而 system prompt 以及使用者輸入的部分,是由 estimate_token() 估算得來的。
# src/meowgent/agent.py
...
class Agent():
	...

	def get_context_status_text(...) -> ...:
		...

		if self.true_token:

            system_prompt_token_gap = 0
            if self.last_system_prompt and self.last_system_prompt != system_prompt:
                system_prompt_token_gap = estimate_token(
	                system_prompt
                ) - estimate_token(self.last_system_prompt)
                # 算出舊的跟新的差多少

            input_token = estimate_token(user_input) if user_input else 0

            total_token = self.true_token + system_prompt_token_gap + input_token
            # 已有的真實 token(前幾輪)+ 新的 sys prompt 要補(扣)的 + 當前輸入
也就是在第一輪輸入時,全部的內容都只能靠 estimate_token() 來估算:
# src/meowgent/agent.py
...
class Agent():
	...

	def get_context_status_text(...) -> ...:
		...
		if ...:
			...

		else:

            total_text = system_prompt + (user_input or "")

            total_token = estimate_token(total_text)
最後,把 total_token 轉換為 k 的單位,做四捨六入,以及算出佔用百分比,就可以回傳文字啦!
# src/meowgent/agent.py
...
class Agent():
	...

	def get_context_status_text(...) -> ...:
		...
		total_token_k = round(total_token / 1000, 1) # 單位轉為 k

        percentage = round((total_token / max_context) * 100, 1)

        return f"[{total_token_k}k/{max_context_k}k] {percentage}%"
今天我們先搞定了底層的 token 估算函數,以及核心邏輯 - get_context_status_text()!
明天,我們就要把這個功能正式接上 prompt_toolkit 的右側動態提示(rprompt),讓它能隨著輸入打字即時更新!
(本來想說,上下文用量這部分可以一篇搞定,結果寫著寫著發現內容還不少啊,而且又要寫不完了~)


 iThome鐵人賽
 看影片追技術